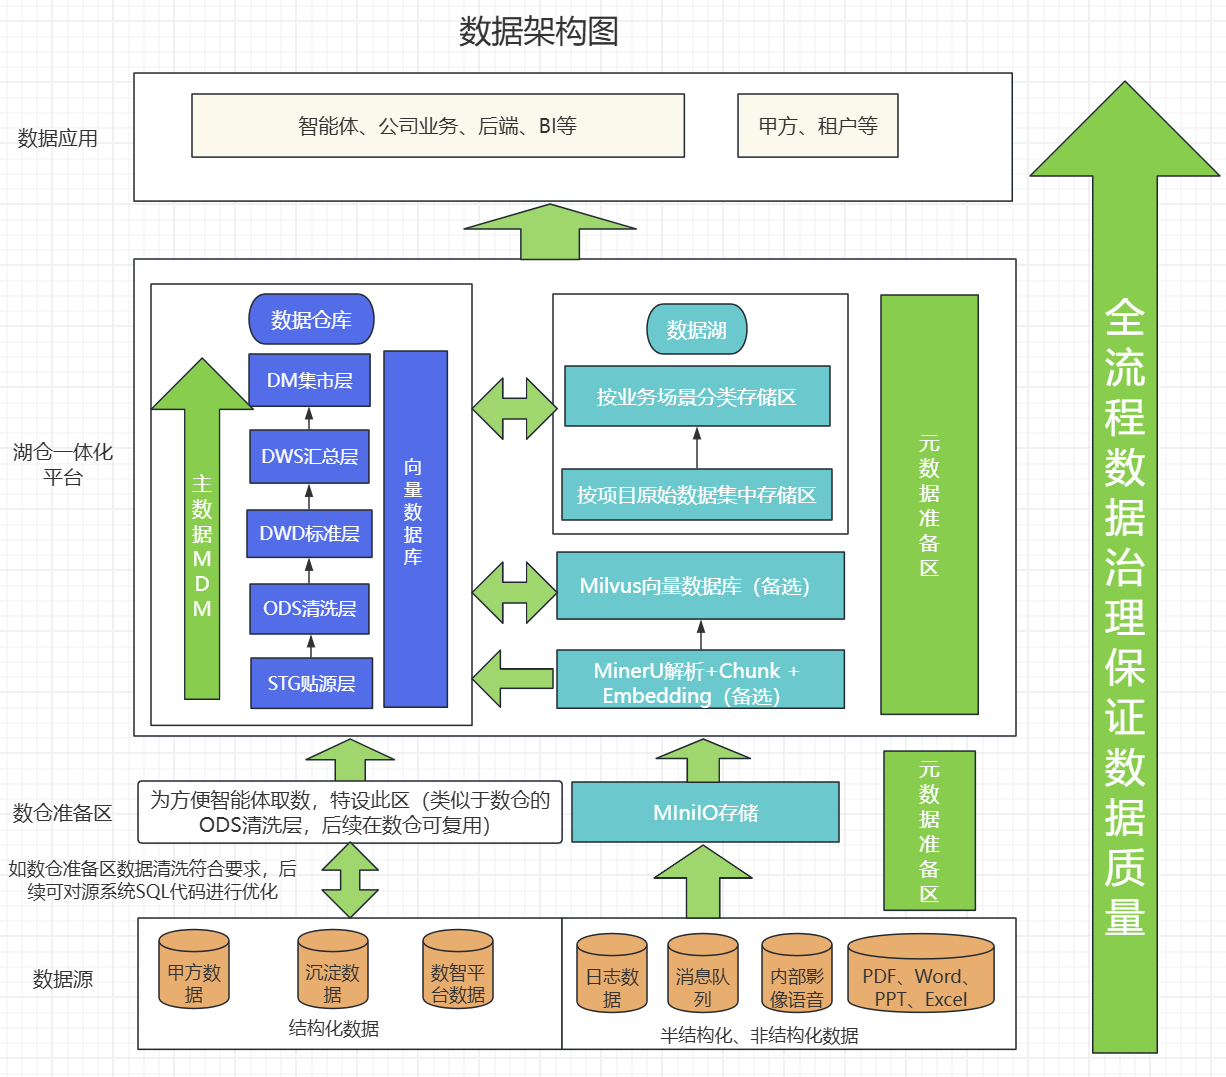
这是我画的一个湖仓架构,我刚入公司没多久,公司着急让我出成果,所以我在湖仓一体化平台这里新建了一个数仓准备区,用以清洗数据,后面让智能体开发直接调用。后面再用左边数据仓库就专门给业务数据分层做数仓使用。右边处理的是非结构化数据,因为现在不清楚湖仓一体化该如何设计。所以就想通过MINIIO+MinerU解析,然后存到左边数仓向量数据库,或者存到Milvus里面。事实上之所以在湖仓一体化平台那里画了那么多的双向箭头,是因为智能体那边要求,数据仓库要和数据湖数据融合,之后根据项目还有业务分类,一起存入到向量数据库,供向量数据库使用。具体该怎么画,麻烦懂的朋友,帮忙给给意见,谢谢。
服务于智能体的Doris湖仓架构该怎么画
Viewed 84

1 Answers
几个简单的个人看法:
1、湖和仓之间双向箭头太多,意味着要维护多个同步任务,可以考虑数据只存一份,在 MinIO 上放 Iceberg/Paimon 表,Doris 内表做分层,通过 External Catalog 直接查湖上的表,查询时通过一条 Doris SQL 自然融合,避免频繁搬数据
2、缺一层统一元数据 Catalog,比如 Gravitino 或者 Lakekeeper,把湖上的表都注册进去统一做管理,权限和凭证发放也在 Catalog 这层,后面 agent 直接取数也可以通过这一层管理,省去单独管理存储区
3、数仓准备区看起来就是把 ODS 又复制了一份,这样后续数据清洗口径容易产生 diff,agent 不太需要专属副本,在数仓本身数据层级上封装视图或者 API 就行
4、向量库规模不大可以直接用 Doris 新版本的向量索引,量大再上 Milvus。MinerU 解析后的结果建议也落湖存储,方便以后重新 embedding,现在业界的趋势也是让向量尽量留在湖仓里,少维护一份同步。

Related Questions